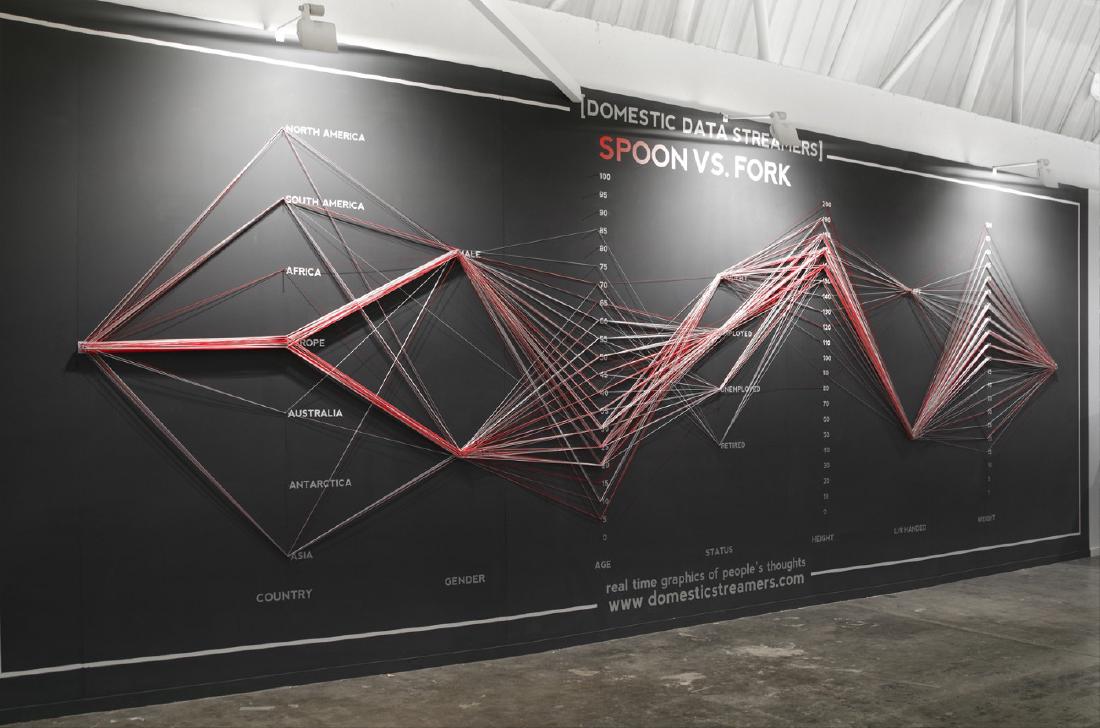
パラレル・コーディネイト(Parallel Coordinates)は、多次元データを可視化するための代表的な手法の一つです。通常、散布図では2軸(x軸とy軸)しか扱えませんが、パラレル・コーディネイトでは複数の垂直軸を平行に配置し、各データ点をそれらの軸上の位置を線で結ぶことで、n次元データのパターンや相関関係を視覚的に把握できます。
この手法は、統計解析、機械学習、データマイニングなどで頻繁に用いられ、特に多変量データの探索的分析(Exploratory Data Analysis, EDA)に有効です。
別名
なし
歴史的経緯
パラレル・コーディネイトの概念は、1959年にAlfred Inselbergによって提唱され、1985年のIEEE論文「The Plane with Parallel Coordinates」で体系化されました。彼はユークリッド空間内の幾何学的構造を平行座標系で表現することを可能にし、後に高次元空間の視覚分析にも応用されました。その後、1990年代以降、可視化ツールや統計ソフトウェア(特にTableauやMatplotlib、D3.jsなど)に実装され、現在ではデータサイエンス教育でも標準的な可視化手法として扱われています。
19世紀から、パラレル・コーディネイトと呼べそうなチャートは存在していました。ただ、コンセプトとして文書化されたものは、1981年、IBM研究者のAlfred Inselbergによるものです。
- A Inselberg. “N-dimensional graphics part I : Lines & hyperplanes”. Technical report, IBM Scientific Center, Los Angeles, CA., 1981.
その後、論文として提案されるのは1990年ですが、同じ年に、統計家が単独で研究した結果を発表しています。
- A. Inselberg & B. Dimsdale:Parallel coordinates: a tool for visualizing multi-dimensional geometry
- Edward J. Wegman(統計家)による提案:Hyperdimensional Data Analysis Using Parallel Coordinates
データ構造
パラレル・コーディネイトでは、各変数(特徴量)が1本の垂直軸に対応します。データセット内の各観測値(レコード)は、これらの軸上で位置を取り、全軸を線分でつなぐことで1本の「経路」として表現されます。
例:
| 変数 | 軸 | 値の例 |
|---|---|---|
| X₁ | Axis1 | 5.1 |
| X₂ | Axis2 | 3.5 |
| X₃ | Axis3 | 1.4 |
| X₄ | Axis4 | 0.2 |
各行(レコード)は、上記のような軸を横断する1本のポリラインとして描かれます。
目的
多次元データにおける「特徴量間の関係性」や「クラスタ構造」「外れ値」「相関傾向」を直感的に理解することが目的です。
特に次のような用途に向いています:
- クラスター間の識別
- 外れ値の発見
- 相関構造の可視化
- 特徴選択や次元削減の前段階の探索
ユースケース
- データサイエンス/機械学習前処理:特徴量間のスケール調整や相関確認
- 品質管理/実験データ分析:多変量プロセスの挙動把握
- マーケティング分析:顧客属性の多次元比較
- バイオインフォマティクス:遺伝子発現データなどの高次元情報解析
特徴
- 多次元データを1つの視覚空間で表現可能
- 軸の順序を変えることで関係性が異なるように見える(軸順序の重要性)
- 線の密集度で傾向を把握できる
- スケーリングや正規化の影響を強く受ける
チャートの見方
各線がデータの1レコードを表し、軸の交点位置が各変数の値を示します。
たとえば、同じような形状の線が複数存在する場合、それらは類似したデータパターンを持つことを意味します。
軸を並べ替えることで、相関の有無やトレンドをより明確にすることもできます。
| 表現要素 | 意味 |
|---|---|
| 垂直軸 | 各変数(ディメンション) |
| 線 | データの1レコード |
| 線の交差 | 変数間の逆相関の可能性 |
| 線の束 | クラスタや共通パターン |
インタラクション
問題点を解決できるようなインタラクションが提案されていることがあります。
軸の並び順と並び替え
軸の並び順ですが、データセットからデータを読みだした際の収録順、類似しているなどなんらかの基準を元にした並び順、属性名の五十音/アルファベット順などが考えられます。
軸を並べ替えることができるようにすれば、ユーザーが知りたいと思う任意の属性を近くに並べることで、相関がわかりやすくなります。ユーザーが手動で行う、軸の性質に応じてなんらかの方法で並び順がシステムから提案されることが考えられます。
ブラッシング
軸ごとにブラッシングを行うことができるようにして、その範囲でデータをフィルタリングします。これにより探索的なデータ可視化が可能となります。
軸の最大値と最小値の入れ替え(軸の上下反転)
Robert Kosaraさんがブログ記事で可能性として提案しています。
デザイン上の注意点
- 軸の順序は分析目的に応じて慎重に決定すること
- 標準化または正規化を行わないと、スケール差で誤解を招く
- データ数が多い場合は、透明度(α値)やサンプリングを利用して過密を防ぐ
- 対話的フィルタリングやブラッシングを併用することで分析が容易になる
以下のような問題点・課題をかかえています。これらの課題を改善するためのインタラクションが実装されている場合があります。
- 近く、もしくは隣接しない軸同士の直接的な相関がわかりづらい。インタラクションを用いて解決することが提案されています。
- データをすべて、表示に利用すると、線が重なりすぎて視認性を損ねることがあります。
- 出力される画面解像度にも寄りますが、軸の数はせいぜい十数個程度が限界でしょう。
応用例
- 交互作用の探索:例えばワインの品質データで酸度・糖度・pHなどを並列表示
- 多クラス分類の可視化:Irisデータセットのように、クラス別に色分けして特徴空間を比較
- 動的視覚化:D3.jsやPlotlyを用いたインタラクティブな探索型ダッシュボード
代替例
- レーダーチャート(Radar Chart):少数の次元で全体像を放射状に表す
- 散布図行列(Scatterplot Matrix):2次元ペアごとの関係を俯瞰する
- パラレル・セット(Parallel Sets):カテゴリカルデータ向けの拡張版
まとめ
パラレル・コーディネイトは、数値変数を多数含むデータセットにおける「関係性・傾向・異常値」を一目で把握するための有力な可視化手法です。
一方で、軸の順序やスケーリング、データ密度への配慮が求められるため、設計段階での工夫が重要です。特に、他の手法(散布図行列や次元削減など)と組み合わせて使うことで、より深い洞察が得られます。